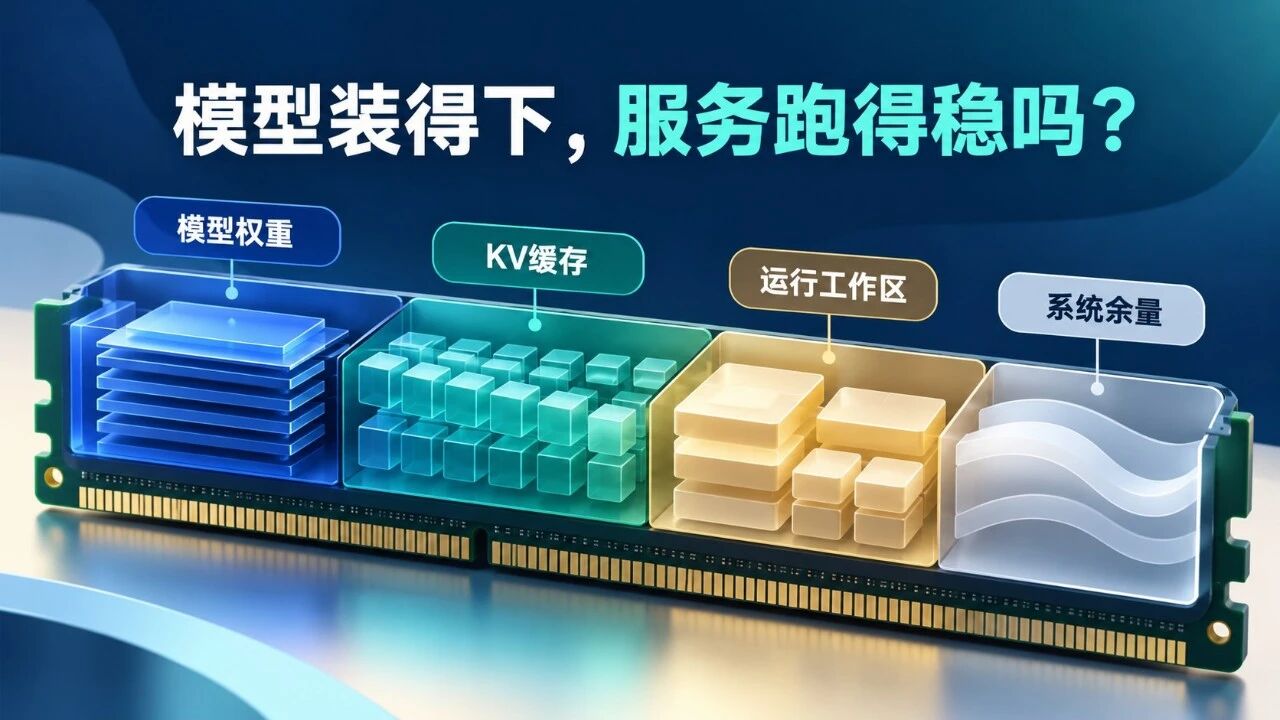
长上下文推理的内存,至少要分成模型权重、KV缓存、运行工作区和系统余量四部分。判断一台设备能否承载服务,不能只看模型文件能否加载,还要把输入长度、输出预留、同时活跃的请求数和实际推理框架放进预算。
对采用常规多头或分组查询注意力、以完整精度保存KV的解码器模型,可以先按层数、KV头数、头维度和缓存token数估算KV载荷,再用实际负载测量修正。这个估算适合选型和排查,不等同于操作系统或推理框架最终报告的内存占用。
为什么模型已经加载,长一点的请求却失败?
把模型载入内存,只完成了服务启动的一部分。生成文本时,每一层注意力通常需要保存此前token的Key和Value,供后续token复用。这部分数据就是KV缓存。对采用全局注意力的普通动态缓存,序列增长会带来更大的缓存需求;并发请求也会扩大同时保留的数据。Hugging Face缓存原理
因此,“空闲状态能启动”“单条短输入能回答”“目标并发下长输入能稳定完成”是三个不同验收条件。一个客服终端的短问答测试通过,不代表它也能同时处理多份产品手册、长对话历史和工具返回内容。最容易遗漏的是输出预算:用户只输入几千token,生成过程仍会继续占用上下文容量。
这里的token是分词器处理后的单位,不能直接换算成固定数量的汉字。中文、英文、代码、表格和特殊符号的分词结果不同。做容量估算,应对实际业务样本使用目标模型的分词器,而不是用文档页数乘一个通用系数。
先建立四栏账,再选择硬件
权重内存是模型参数的载荷;KV缓存随缓存策略、上下文和活跃请求变化;运行工作区包括算子中间结果及框架运行需要的空间;系统余量留给操作系统、驱动、其他进程及波动。四栏应分别记录,避免把某一项当作总需求。
| 预算项 | 优先确认什么 | 常见误判 |
|---|---|---|
| 权重 | 参数规模、实际加载精度、量化格式、额外张量 | 用下载文件大小当运行峰值 |
| KV缓存 | KV头数、层数、缓存精度、上下文、活跃序列 | 只看模型标称参数量 |
| 运行工作区 | 推理后端、批处理、预填充方式、算子实现 | 把首轮峰值忽略掉 |
| 系统余量 | 可用内存、共享资源、后台业务、异常恢复 | 把物理容量全部分给模型 |
例如,70亿参数乘以每参数2字节,得到约140亿字节的权重载荷,约14GB十进制容量。这只是便于理解的算术示例,未计入框架、额外张量和缓存,也没有证明某个7B模型在14GB设备上能够运行。量化权重可能改变这一项,但量化是否同时作用于KV,需要单独确认。
KV缓存怎样手算?
在普通decoder-only模型、各层使用同样的KV维度且不考虑压缩等额外机制时,可以用下面的载荷公式:
KV字节数 ≈ 2 × 层数 × KV头数 × 头维度
          × 已缓存token数 × 活跃序列数 × 每元素字节数
其中“2”对应Key和Value。Hugging Face文档给出的缓存张量按批次、头、序列长度和头维度组织;公式是在逐层Key、Value张量上展开的容量计算。缓存张量结构
采用分组查询注意力时,必须取模型的KV头数,不能直接把Query头数代入。还要核对实际配置字段和推理实现:不同架构可能使用滑动窗口、潜在注意力、混合层或其他缓存组织方式,不能套同一个表达式就结束选型。
设一个纯计算示例:32层、8个KV头、每头128维、每元素2字节,单条序列缓存8192个token。计算得到1,073,741,824字节,即1GiB。若8条序列都达到这一缓存长度,普通未共享载荷约为8GiB。这里的GiB按二进制计算;它不是某款模型、某张显卡或某个产品的实测结果。
这个例子说明了一个选型风险:模型权重不变,活跃请求和上下文长度的组合,仍可能改变服务容量。采购需求书至少要同时写出输入长度分布、输出上限和目标并发,单独写“支持8K上下文”不足以确定整机配置。
缓存策略会改变什么?
Dynamic Cache按需要增长;Static Cache预留固定空间,可能更适合某些编译优化,但预留部分也占资源。量化缓存用不同数据表示压缩载荷,可能引入处理开销和适用条件;卸载缓存将数据移到其他存储层,也会改变传输和时延。具体支持取决于模型及后端。Hugging Face缓存策略
因此不能把“开启缓存优化”理解成统一的内存折扣。比较两个配置时,应明确是在比较固定最大长度预分配,还是当前请求实际使用的缓存;是在比较设备显存,还是把部分压力转移到了主机内存。只截图一个空闲时刻的显存数,难以说明业务容量。
滑动窗口模型的部分层可能只保留有限窗口,而全局注意力层仍有不同需求。即使框架支持某类缓存,也要确认当前模型是否使用该实现。对于架构特殊、缓存压缩或多设备分片的模型,应优先查官方配置和框架说明,手算仅作合理性检查。
前缀缓存可以省下多少?
前缀缓存复用匹配输入前缀的计算或缓存数据,适合系统提示、固定说明等重复内容。Modular的MAX文档说明了其前缀缓存机制;2026年10月22日的26.7更新也介绍了KV缓存相关变化。MAX前缀缓存|26.7更新
这种收益依赖命中条件。不同用户的独特长文、频繁变化的工具结果和不同排列顺序,未必可以复用同一前缀。做容量承诺时,不能默认所有请求都会命中;应分别测试冷缓存、可复用前缀和几乎不复用的负载。缓存让某些重复输入更快,并不自动证明任意输出生成都获得同样提升。
采购和验收可以先以保守的不共享负载确定可运行下限,再记录真实业务中的命中率及收益。这样既能利用优化,也能知道优化失效时系统是否仍有退路。
把业务样本变成容量测试
先整理三组脱敏样本:典型输入、较长但合理的输入,以及接近产品允许边界的输入。为每组固定输出长度、模型版本、分词器版本和工具结果规模,再逐步提高活跃请求数。不要同时更换模型、精度和缓存方式,否则失败后难以确定原因。
每次至少记录启动后的常驻占用、预填充峰值、持续生成峰值、完成后的资源释放情况,以及失败请求的错误类型。计时则分开记录首token时间、持续生成速度和完整请求时长。MAX的基准文档也将首token、后续token时延和吞吐作为不同指标;它们对应的用户体验并不相同。基准指标说明
如果系统还承担摄像头处理、音频缓冲、设备管理或其他业务,需要让这些任务同时运行再测。共享内存设备尤其要确认内存竞争,而不是把处理器可访问的总容量全部当成模型专用资源。
预算不够时,按什么顺序调整?
先确认是否存在不必要的上下文:重复系统提示、完整历史逐轮累加、未经筛选的检索段落和过长工具结果,都可能扩大输入。保留必要证据,限制返回数量,通常比简单提高最大上下文更容易形成可控产品。摘要和截断也会影响事实完整性,需要业务样本复核。
随后调整并发和排队规则,把活跃序列与等待请求分开;再评估输出上限、模型规模、权重精度和支持的缓存策略。每一次调整都应重新检查任务质量。减小模型或压缩缓存,只解决资源问题的一部分,不能用内存下降代替准确性验收。
最后才考虑升级容量或拆分服务。如果业务本来是设备端采集、中心端推理,可以先测真实网络条件和服务失败时的设备行为。不要因为开发机可以承载长上下文,就默认终端板卡也具备同样预算。
交付资料里应该留下什么?
一份可复用的容量记录,应包含模型及revision、加载精度、缓存实现、框架与驱动版本、硬件、可用资源、输入输出长度、活跃请求数、测试样本和结果。另列最坏负载下的失败行为,例如排队、拒绝超长请求、缩短输出或切换服务,避免压力上来时只剩进程退出。
普众的AI硬件方案覆盖板卡、智能体和控制系统的协同设计。对这样的产品项目,内存预算可以与接口、任务时限和验收样本放在同一份需求表中,让模型选择与设备约束一起评审。AI硬件软硬一体方案
当团队能够回答“什么输入、多少活跃请求、使用哪种缓存、保留多少资源、失败时怎么办”,容量预算才从一个硬件参数变成了能够复核的交付条件。